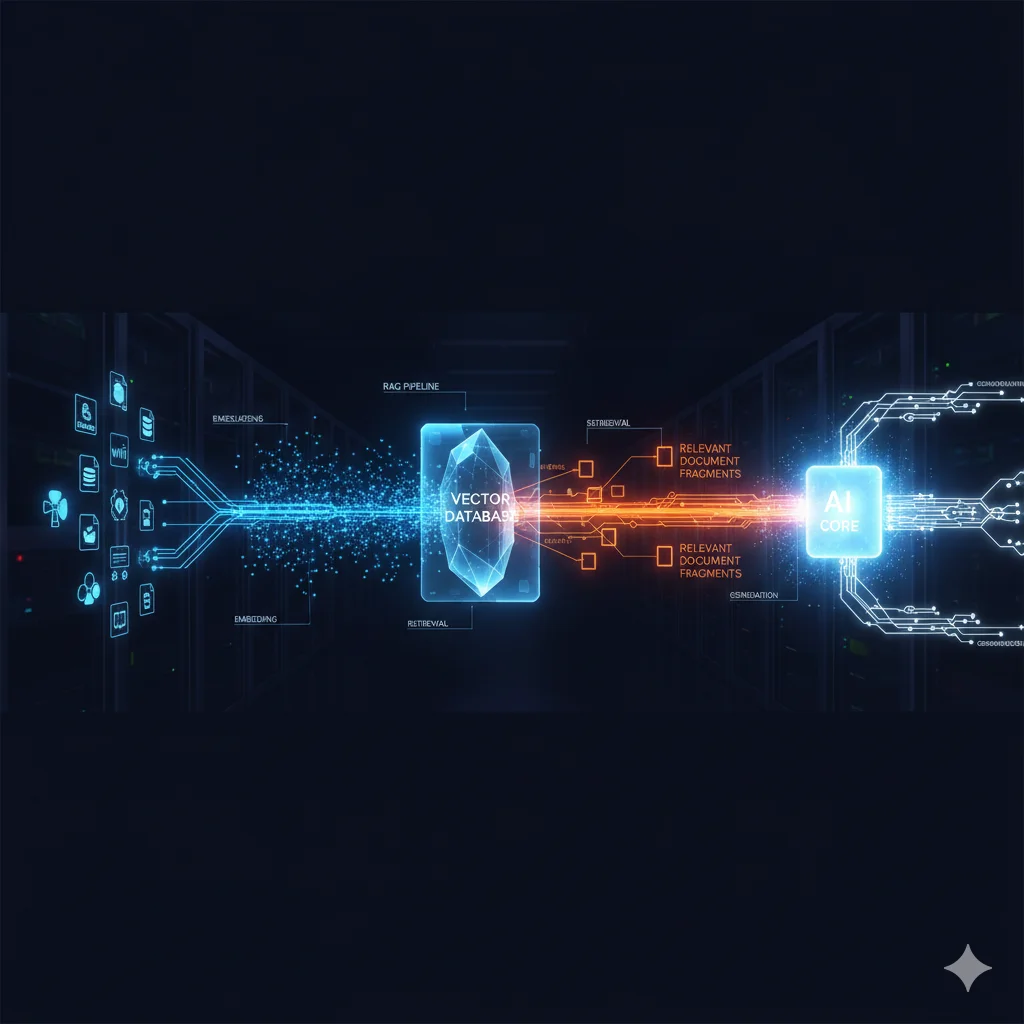
Eigene Daten in die KI bringen – mit RAG.
Standard-KI kennt Ihr Unternehmen nicht. Mit RAG und Embedding-Technologie geben Sie der KI Zugriff auf Ihr Firmenwissen – sicher und kontrolliert.
Was ist ein RAG-System?
Ein RAG-System verbindet ein Sprachmodell mit einer Suche in Ihren eigenen Dokumenten. Stellt jemand eine Frage, sucht das System zuerst die passenden Textstellen in Ihren Unterlagen und übergibt nur diese an die KI, die daraus die Antwort formuliert.
Der Nutzen liegt in zwei Punkten: Die KI antwortet mit Ihrem Firmenwissen statt mit Allgemeinplätzen, und sie kann jede Aussage auf ein Dokument zurückführen. Erfundene Antworten werden dadurch selten – und wenn etwas nirgends steht, sagt ein gut gebautes System genau das. Wie das im Unternehmensalltag aussieht, zeigt unser Beitrag RAG-System: Firmenwissen mit KI nutzbar machen.
Die Abkürzung steht für Retrieval-Augmented Generation, auf Deutsch etwa „Erzeugung mit vorgeschalteter Suche“. Nichts am Modell wird dabei verändert – Ihre Daten bleiben in Ihrer Datenbank.
Was RAG ausdrücklich nicht ist
-
Kein Training.
Ihre Dokumente werden nicht ins Modell eingelernt. Sie liegen in einer Datenbank daneben und lassen sich jederzeit ändern oder löschen. -
Keine Volltextsuche mit Chatfenster.
Gesucht wird nach Bedeutung, nicht nach Wortübereinstimmung. Wer nach „Urlaubsanspruch“ fragt, findet auch den Abschnitt über „Erholungsurlaub“. -
Kein Selbstläufer.
Die Technik ist Standard. Die Arbeit steckt in den Dokumenten und in den Berechtigungen – dazu weiter unten mehr.
Warum Standard-KI Ihr Unternehmen nicht kennt
Sprachmodelle wie Llama oder Mistral wurden auf öffentlichen Texten trainiert. Ihr internes Wiki, Ihre Produktdokumentation, Ihre Kundenhistorie, HR-Richtlinien und Projektdaten – all das ist der KI völlig unbekannt. Ohne diese Informationen sind Antworten zu generisch, um im Arbeitsalltag wirklich nützlich zu sein.
RAG (Retrieval-Augmented Generation) löst dieses Problem: Bevor die KI antwortet, durchsucht sie Ihre eigenen Daten nach relevanten Informationen und nutzt ausschließlich dieses verifizierte Firmenwissen als Kontext. Das Ergebnis: präzise Antworten mit Quellenangabe – ohne teures Nachtrainieren des Modells.
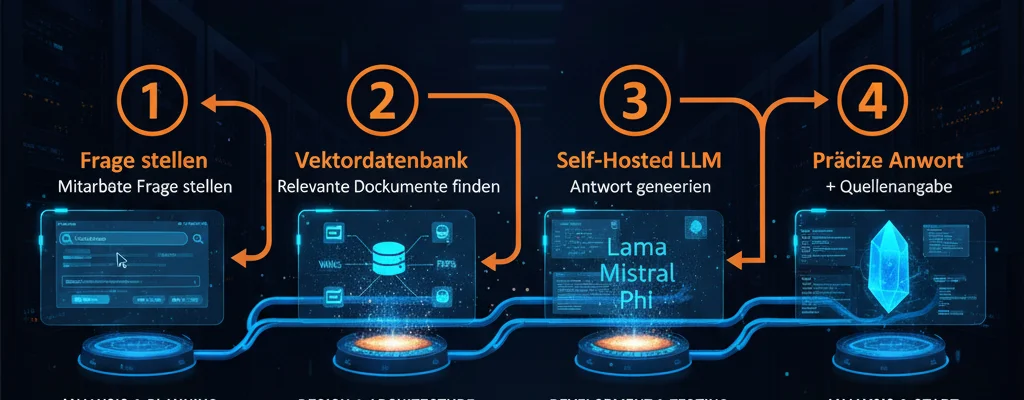
Die 5 Phasen der RAG-Pipeline
Welche Datenquellen wir anbinden
Wir integrieren Ihre vorhandenen Systeme als Wissensbasis für die KI. Jede Quelle wird automatisch indiziert und über die Vektordatenbank semantisch durchsuchbar gemacht.
Dokumente
PDFs, Word-Dateien, Excel-Tabellen, Präsentationen – direkt indizierbar.
Wiki & Dokumentation
Confluence, Notion, MediaWiki, interne Handbücher – als Wissensbasis nutzbar.
Ticketsysteme
Jira, Freshdesk, Zendesk – Support-Verlauf als Kontext für die KI nutzbar.
Nextcloud / Fileshares
Dateien aus Nextcloud oder SMB-Shares automatisch in die Wissensbasis einbinden.
Datenbanken
Strukturierte Daten aus ERP, CRM oder eigenen Datenbanken für die KI zugänglich machen.
E-Mails & Kalender
E-Mail-Verläufe und Kalendereinträge als Kontext – z.B. für Support-Assistenten oder automatisierte Terminzusammenfassungen.
Hybrid Search: Vektorsuche und Keyword-Suche kombiniert
Reine Vektorsuche versteht den Kontext hinter einer Frage gut, stößt aber bei exakten Begriffen wie Artikelnummern, Fehlercodes oder juristischen Paragrafen an ihre Grenzen.
Deshalb setzen wir auf Hybrid Search: Die Kombination aus semantischer Vektorsuche und klassischer Keyword-Suche sorgt dafür, dass sowohl inhaltlicher Kontext als auch exakte Fachbegriffe zuverlässig gefunden werden.
Der Effekt ist messbar und größer, als man vermuten würde: Gegenüber einer reinen Vektorsuche sinkt die Fehlerrate um rund die Hälfte. Kommt ein nachgeschaltetes Reranking hinzu, das die gefundenen Stellen noch einmal genauer bewertet, sind es etwa zwei Drittel.
Das sind zwei Bausteine, die im Aufbau wenig kosten und im Ergebnis den Unterschied machen zwischen einem System, dem die Leute vertrauen, und einem, das nach zwei Wochen niemand mehr öffnet.
Versteht Bedeutung und Zusammenhänge. Findet Antworten auch bei anderer Wortwahl.
Trifft exakte Begriffe: Produktcodes, Paragrafennummern, Eigennamen.
Sortiert die kombinierten Ergebnisse nach Relevanz – für maximale Präzision.
Jede Antwort referenziert die Originalquelle – nachvollziehbar und auditierbar.
RAG, Fine-Tuning oder einfach alles in den Kontext?
Drei Wege, einer KI Firmenwissen zugänglich zu machen. Sie werden regelmäßig verwechselt, und die Wahl entscheidet über Kosten und Aufwand.
| RAG | Fine-Tuning | Langer Kontext | |
|---|---|---|---|
| Wofür gedacht | Wissen, das sich ändert | Tonfall, Format, Fachsprache | Einzelne Dokumente ad hoc |
| Neues Dokument einpflegen | Sekunden | Neues Training nötig | Bei jeder Frage erneut |
| Etwas löschen | Aus der Datenbank entfernen | Kaum verlässlich möglich | Entfällt, nichts wird gespeichert |
| Quellenangabe | Von Haus aus | Nicht möglich | Möglich |
| Laufende Kosten | Überschaubar | Gering, aber Training kostet | Hoch – Speicherbedarf wächst je Nutzer |
Warum große Kontextfenster RAG nicht ersetzen
Moderne Modelle können sehr lange Texte auf einmal lesen, und die naheliegende Idee lautet: einfach alle Dokumente hineinkippen. In der Praxis scheitert das an zwei Dingen. Erstens sinkt die Trefferquote, je mehr Material gleichzeitig im Kontext liegt – das Modell übersieht Stellen mitten im Text. Zweitens belegt jeder offene Gesprächsverlauf Grafikspeicher, und zwar erheblich.
Bei einem großen Modell mit sehr langem Kontext kann allein der Speicher für den Gesprächsverlauf mehrere Dutzend Gigabyte je Nutzer beanspruchen. Bei einer Handvoll gleichzeitiger Anfragen ist keine Hardware mehr bezahlbar. Die vorgeschaltete Suche ist deshalb kein Notbehelf aus der Zeit kleiner Kontextfenster, sondern die günstigere Bauweise.
Wann Fine-Tuning trotzdem sinnvoll ist
Wenn es nicht um Wissen geht, sondern um Form. Soll die KI durchgängig Ihre Fachbegriffe verwenden, ein bestimmtes Antwortformat einhalten oder in einem festen Tonfall schreiben, ist Nachtrainieren der richtige Weg.
Für die Frage „Was steht in unserem Wartungsvertrag?“ ist es der falsche. Wir sehen häufig, dass Fine-Tuning vorgeschlagen wird, wo eine Suche das Problem schneller, billiger und nachvollziehbarer löst.
Woran RAG-Projekte scheitern
Fast nie an der Technik. Die vier häufigsten Ursachen liegen alle davor oder daneben.
1. Die Dokumente
Der mit Abstand größte Posten. Der überwiegende Teil aller Genauigkeitsprobleme geht nicht auf das Modell oder die Datenbank zurück, sondern auf die Unterlagen: drei Versionen desselben Handbuchs, gescannte Seiten mit Lesefehlern, veraltete Preislisten ohne Datum.
Ein RAG-System löst Widersprüche nicht auf, es gibt sie weiter. Deshalb geht in ehrlichen Projekten ein erheblicher Teil des Aufwands ins Sichten und Aufräumen der Quellen – und nicht in die Software.
2. Berechtigungen zu spät gedacht
Der klassische Fehler: Erst wird gesucht, dann wird aussortiert, was die fragende Person nicht sehen darf. Das Ergebnis sind leere Antworten, obwohl passende freigegebene Dokumente vorhanden wären – und im schlimmeren Fall Inhalte, die durchrutschen.
Richtig ist der umgekehrte Weg: Die Berechtigung ist Teil der Suchanfrage. Gesucht wird von vornherein nur dort, wo die Person zugreifen darf. Das ist auch die Erwartung der Aufsichtsbehörden – siehe DSGVO-konforme KI.
3. Gebaut ohne die Fachabteilung
Ein System, das die IT allein entwirft, beantwortet die Fragen, die sich die IT vorstellt. Die Fragen, die im Tagesgeschäft wirklich gestellt werden, sind andere und meist unpräziser formuliert. Wir sammeln sie deshalb vorab – echte Fragen von echten Leuten, bevor irgendetwas gebaut wird.
4. Struktur beim Zerlegen verloren
Dokumente werden für die Suche in Abschnitte zerlegt. Geschieht das stur nach Zeichenzahl, landet die Hälfte einer Tabelle im einen und die andere Hälfte im nächsten Abschnitt, und die Überschrift fehlt in beiden.
Wir zerlegen entlang der Struktur – Kapitel, Absätze, Tabellen bleiben zusammen – und geben jedem Abschnitt mit, aus welchem Dokument und welchem Kapitel er stammt.
Welche Bausteine dabei zum Einsatz kommen und woran wir sie auswählen, steht unter KI-Technologien.
Woran man erkennt, ob es funktioniert
„Fühlt sich gut an“ ist kein Abnahmekriterium. Die Qualität eines RAG-Systems lässt sich messen, und wir tun das vor der Übergabe – mit echten Fragen aus Ihrem Haus und geprüften Musterantworten.
Gemessen wird getrennt nach zwei Dingen: ob die Suche die richtigen Stellen gefunden hat, und ob die Antwort tatsächlich nur auf diesen Stellen beruht. Diese Trennung ist wichtig, weil beide Fehler unterschiedlich behoben werden. Findet die Suche nichts, hilft ein anderes Suchverfahren. Erfindet das Modell trotz guter Fundstellen, hilft eine andere Anweisung.
Die vier Kennzahlen
- Belegbarkeit – Wie viele Aussagen der Antwort stehen tatsächlich in den gefundenen Dokumenten? Die wichtigste Zahl gegen erfundene Antworten.
- Antwortbezug – Beantwortet die Antwort die gestellte Frage, oder redet sie daran vorbei?
- Trefferreihenfolge – Stehen die relevanten Fundstellen weit oben oder gehen sie im Rauschen unter?
- Vollständigkeit – Hat die Suche alles gefunden, was für eine korrekte Antwort nötig gewesen wäre?
Alle vier werden auf einer Skala von 0 bis 1 angegeben. Werte ab etwa 0,8 gelten als brauchbar. Wichtiger als der Absolutwert ist, dass er über die Zeit gemessen wird – so fällt auf, wenn neue Dokumente das Ergebnis verschlechtern.
Was damit möglich wird
Wissens-KI
Mitarbeiter stellen Fragen an die interne Wissensdatenbank – die KI findet und erklärt die Antwort.
→ Use Case ansehenSupport-Assistent
Die KI schlägt Antworten auf Basis echter vergangener Tickets vor – schnellere Bearbeitung, weniger Rückfragen.
→ Use Case ansehenVertriebs-KI
Produktinfos, Preislisten und Kundendaten als Kontext – die KI beantwortet Kundenanfragen präzise und konsistent.
Mehr zum Thema im Blog
RAG-Systeme: Unternehmenswissen per KI nutzen
RAG-Systeme verbinden ein Sprachmodell mit Ihrem Firmenwissen – ohne eigenes KI-Training. Wie das funktioniert und wann es sich lohnt.
Weiterlesen →
Was sind Token, Kontextfenster und Modellgrößen? KI-Begriffe einfach erklärt
70B, 128k Tokens, Kontextfenster – was bedeutet das wirklich? Die wichtigsten KI-Begriffe für Entscheider, Projektleiter und IT-Verantwortliche ohne Formeln erklärt.
Weiterlesen →Fragen zu RAG und eigenen Daten
Wie nutzt eine KI unsere eigenen Daten?
Über ein RAG-System (Retrieval Augmented Generation). Dabei wird das Sprachmodell nicht neu trainiert — es bekommt zur Frage die passenden Stellen aus Ihren Dokumenten mitgeliefert und antwortet auf dieser Grundlage. Der Vorteil: Neue Dokumente wirken sofort, und die KI kann angeben, woher eine Aussage stammt.
Müssen wir dafür ein eigenes KI-Modell trainieren?
Nein, und das ist auch selten sinnvoll. Ein eigenes Modell zu trainieren kostet ein Vielfaches und veraltet mit jeder neuen Modellgeneration. Ein RAG-System nutzt ein bestehendes Modell und reichert es mit Ihrem Wissen an — schneller, günstiger und jederzeit aktualisierbar.
- Warum eine eigene KI?
- ChatGPT oder eigene KI?
- KI selbst hosten
- Lokale KI: Hardware und Grenzen
- KI-Benchmark: eigene Messwerte
- Die eingesetzten Technologien
- KI-Modelle im Vergleich
- Datenschutz & DSGVO
- KI-Server & Preise
- KI-Portal: Tarife und Preise
- Wie eine eigene KI aufgebaut ist
- Betriebsmodelle im Vergleich
- Anwendungsfälle
- Häufige Fragen zur eigenen KI
- Demo: So arbeitet ein Firmen-Chatbot
- Wie man anfängt
Beratung zu RAG – bevor gebaut wird.
Wir schauen uns Ihre Dokumente an und sagen Ihnen, was ein RAG-System daraus machen kann und was nicht. Diese Einschätzung ist der ehrlichste Teil des Projekts.
Direkter Kontakt – ohne Umwege. Wir melden uns innerhalb eines Werktages.