Coding Harness: Wie KI Zugriff auf die reale Welt bekommt
Ein Sprachmodell liefert nur Text. Erst der Harness lässt es Dateien lesen und Befehle ausführen. Was dahintersteckt, was es kostet und wo die Grenzen liegen.
Lieber ansehen statt lesen? Der Artikel als Video.
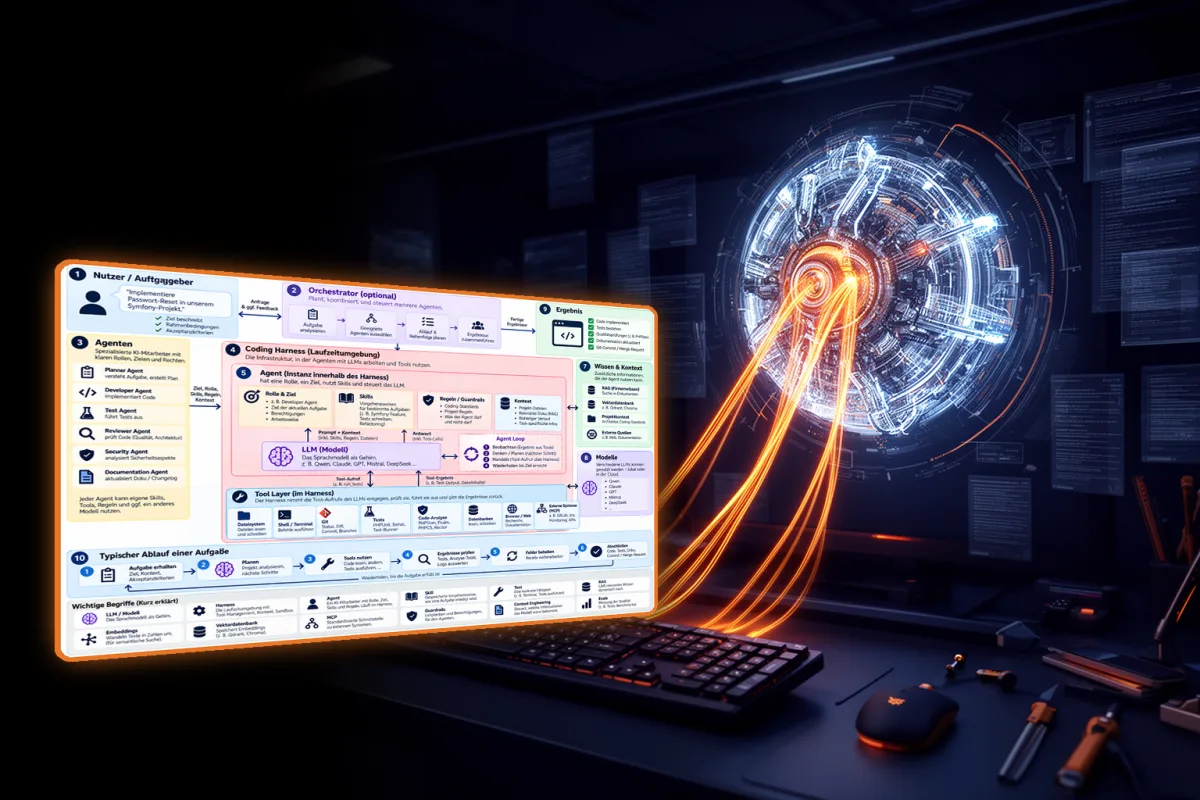
Kurz gesagt:
- Ein Sprachmodell erzeugt nur Text. Erst der Coding Harness lässt das Modell Dateien lesen und Befehle ausführen. Codex, Claude Code und OpenCode sind solche Harnesse.
- Für die meisten Aufgaben reichen die fertigen Harnesse. Wer selbst einen baut, pflegt ihn danach dauerhaft: Ich habe nach vier eigenen Versionen aufgehört.
- Skills und Hooks holen aus kleinen, lokalen Modellen spürbar mehr heraus, weil sie Wissen und Prüfregeln fest in den Ablauf einbauen.
- Was sich klar in Regeln fassen lässt, gehört in klassischen Code. Ein Werkzeug wie PHPStan findet Regelverstöße zuverlässiger als jedes Sprachmodell.
Was ein Coding Harness ist
Ein großes Sprachmodell (LLM) ist aus riesigen Textmengen trainiert und sagt Stück für Stück voraus, wie ein Text weitergeht. Von sich aus kann es nichts tun: Es gibt nur Text zurück. Damit es trotzdem in einem Projekt arbeiten kann, gibt es Tool-Calling: Das Modell fordert gezielt ein Werkzeug an, die Software drumherum führt es aus und liefert das Ergebnis zurück.
Diese Software drumherum ist der Coding Harness. Er läuft als Code um das Sprachmodell herum und macht es erst zum handelnden Agenten. Erst der Harness lässt das Modell Dateien lesen und Befehle ausführen. Ein KI-Agent ist dann ein Programm, das komplexe Aufgaben in mehreren Schritten selbstständig plant und erledigt.
Der Begriff wird ähnlich pauschal benutzt wie DevOps, also die enge Zusammenarbeit von Entwicklung und IT-Betrieb mit gemeinsamen Prozessen und Werkzeugen: Jeder versteht etwas leicht anderes darunter. Die bekanntesten Harnesse sind diese drei:
| Harness | Von | Quelltext | Besonderheit |
|---|---|---|---|
| Codex | OpenAI | Open Source (Apache 2.0) | Läuft lokal auf deinem Rechner im Terminal |
| Claude Code | Anthropic | Closed Source | Liest deinen Code, ändert Dateien, führt Befehle aus |
| OpenCode | Anomaly | Open Source (MIT) | Arbeitet mit vielen Modellen, auch mit solchen, die lokal laufen |
Hinter Claude Code steht Claude, die Modellfamilie von Anthropic mit Opus, Sonnet und Haiku. Über das Model Context Protocol (MCP), einen offenen Standard, bindet ein Harness weitere Werkzeuge und Datenquellen an, etwa ein Dateisystem, eine Datenbank oder eine API. Einmal angebunden, lässt sich so eine Quelle in vielen KI-Anwendungen nutzen.
Welche Harnesse es noch gibt
Neben den großen drei gibt es eine wachsende Zahl kleinerer Harnesse, die sich vor allem zum Experimentieren eignen:
- Pi ist ein minimaler, erweiterbarer Agent-Harness. Du passt ihn an deinen Ablauf an, nicht umgekehrt.
- Der DeepSeek-Harness ist Open Source, startet lokal eine Web-Oberfläche, und jede Funktion kommt als Plugin dazu. Er ist noch eine Entwicklervorschau.
- Hermes Agent von Nous Research baut sich ein Gedächtnis auf und legt aus erledigten Aufgaben eigene Skills an.
- OpenClaw ist ein Open-Source-Assistent auf dem eigenen Rechner, steuerbar über Chat-Apps wie WhatsApp oder Telegram.
Auch eine Chat-Oberfläche wie Open WebUI ist im Grunde schon ein Harness: Sie läuft selbst gehostet und bündelt Modelle, Chats und Werkzeuge an einem Ort.
Fertig nehmen oder selbst bauen?
Für die meisten reicht ein Harness von der Stange. Wer selbst baut, pflegt ihn danach für immer. Das ist wie bei Kleidung: Viele kommen mit Konfektionsware gut zurecht, manche brauchen Maßanfertigung.
Ich habe vier eigene Harnesse gebaut. Die erste Version entstand, als lokale Modelle noch kein Tool-Calling konnten; von zehn Anfragen kamen acht als brauchbares JSON zurück. Heute steuere ich stattdessen fertige Harnesse über ein Terminal. Das Nachziehen jeder neuen Modellgeneration war zu aufwendig. Für etwas so Komplexes ist Vibe-Coding, also Software fast nur über Anweisungen an die KI entstehen zu lassen, der falsche Ansatz.
Zwischen Fertigprodukt und Eigenbau liegen Workflow-Sammlungen:
- GSD führt einen Coding-Agenten durch feste Phasen: besprechen, planen, umsetzen, prüfen, ausliefern. Umgesetzt wird jeweils mit frischem Kontext.
- Superpowers bringt Agenten wie Claude Code eine feste Entwicklungsmethode bei: erst fragen, was du wirklich willst, dann planen.
Ein Projekt ist in vier Varianten entstanden, auf der grünen Wiese und in bestehendem Code (Greenfield und Brownfield), mit und ohne solche Sammlungen. Die gemeinsame Planung hat geholfen. Frei gearbeitet war das Ziel aber teils schneller erreicht, bei gleicher Qualität.
Warum die Sammlungen ins Geld gehen, zeigt ein Blick auf die Tokens, die Textbausteine, mit denen ein Modell rechnet und nach denen abgerechnet wird. Jede Phase schreibt Pläne und Zwischenstände, die der Agent immer wieder liest. Das füllt das Kontextfenster, also das, was ein Modell auf einmal berücksichtigen kann. Lokal kommt der Prefill dazu: Bevor das erste Wort der Antwort kommt, verarbeitet das Modell den ganzen Eingabetext. Laufen mehrere Agenten parallel, muss jeder Kontext immer wieder neu eingelesen werden. Und Zeit ist bei KI am Ende Geld.
Skills, Hooks und feste Regeln
Ein Skill ist im Kern ein gespeicherter Prompt, aber einer, den der Agent selbst findet, wenn er passt. Technisch ist ein Skill ein Ordner mit einer Anleitung (SKILL.md) und gegebenenfalls Skripten, den ein Agent bei Bedarf lädt. Gegenüber einem Prompt, den du jedes Mal neu schreibst, hat das einen großen Vorteil. Du vergisst nichts mehr.
Mein Beispiel ist eine einzige Zeile in meinem Prüf-Skill: Eine Webseite darf keine Ressourcen von fremden Servern laden. Genau das hat vor einigen Jahren bei über ein CDN eingebundenen Google-Schriften Abmahnungen ausgelöst. Wenn die KI Code schreibt, denkt man nicht jedes Mal daran, ihn genau darauf zu prüfen. Und baut später ein Kollege so etwas ein und es rutscht durch das Code-Review, fällt es dem Skill beim nächsten Prüflauf auf.
Damit die Prüfung nicht vom Zufall abhängt, gibt es Hooks: automatisch ausgelöste Aktionen an festen Punkten, etwa ein Prüfskript, sobald der Agent fertig ist. Die eigentliche Prüfarbeit erledigen dabei klassische Werkzeuge:
| Werkzeug | Prüft |
|---|---|
| PHPStan | Fehler in PHP-Code, ohne dass du Tests schreiben musst, auch in selten ausgeführten Zweigen |
| Deptrac | Architekturregeln, z. B. welche Schicht welche andere nutzen darf |
Sobald du eine Aufgabe klar genug eingrenzen kannst, um sie in Code zu gießen, ist Code schneller, ressourcenschonender und im Ergebnis verlässlicher. PHPStan meldet jeden Verstoß gegen seine Regeln. Ein Sprachmodell, das du bittest, ein Projekt auf dieselben Regeln zu prüfen, lässt dagegen regelmäßig Fehler stehen.
Das passende Modell für die Aufgabe
Lokal braucht jede Aufgabe das passende Modell. Zwei, die wir täglich einsetzen:
- Qwen ist eine offene Modellfamilie (Apache 2.0). Qwen3.8 27B ist ein dichtes Modell mit 27 Milliarden Parametern.
- Ornith ist ein offenes Coding-Modell (MIT-Lizenz) mit rund 35 Milliarden Parametern, von denen pro Token nur etwa 3 Milliarden rechnen. Das ist das Prinzip Mixture of Experts: viele Teilnetze, von denen jeweils nur wenige arbeiten, was Rechenzeit spart.
Für Texte statt Code taugen andere Modelle. Für Geschichten gibt es etwa Cydonia, ein Schreibmodell auf Basis von Mistral Small 3.2. Werkzeuge aufrufen kann es allerdings nicht. Dann steuert eben Qwen den Ablauf, sammelt die Informationen und gibt nur das Schreiben an Cydonia ab.
Dabei zeigt sich ein Problem von Reasoning-Modellen, die eine Aufgabe erst in Zwischenschritten durchdenken, bevor sie antworten: Die Denkschritte landen im Kontext, und das Modell beginnt, ihren Stil zu kopieren statt den der Geschichte. Hilfreich ist eine Continuity-Datei, auch Story Bible genannt. Sie hält Figuren, Orte und Handlung fest, damit die Details über alle Kapitel stimmig bleiben.
Offene Modelle findest du auf Hugging Face, der zentralen Plattform für Modelle und Datensätze. Viele Varianten dort sind feingetunt, also mit eigenen Beispielen für eine Aufgabe nachtrainiert.
An der Spitze stehen die Frontier-Modelle, die jeweils leistungsfähigsten Modelle ihrer Zeit. Bei OpenAI ist das aktuell die GPT-6-Reihe, in Codex etwa GPT-6.1 Sol. Wer ChatGPT als Cloud-Dienst nutzt, sollte wissen: Wer zustimmt, lässt seine Inhalte ins Training von OpenAI einfließen. Viele Firmen verbieten es deshalb für sensible Daten.
Bleibt KI-Code wartbar?
Mit der Spiele-Engine Godot ist eine 3D-Trainingsanwendung entstanden, die auf Tablet, Handy und Windows läuft. Sie funktioniert. Wer den Code aber selbst öffnet, findet sich kaum zurecht. Für eine Maschine mag der Code lesbar sein, für einen Menschen ist er es oft nicht.
Steuern lässt sich das. Agenten bekommen feste Paradigmen vorgegeben, etwa Test Driven Development: erst der Test, dann der Code, der ihn erfüllt. Und in regelmäßigen Abständen sucht ein eigener Architektur-Agent nach Problemen, ein anderer räumt auf.
Die größere Frage ist, wie die nächste Generation Entwickler das Fachwissen lernt. Kaum jemand schreibt heute noch Assembler, die maschinennahe Sprache direkt für einen Prozessortyp. Wir haben uns damals eine Ebene nach oben bewegt, und mit KI geschieht das gerade wieder. Solange die Ergebnisse nicht immer stimmen, bleibt der Mensch als Human in the Loop fest im Ablauf und entscheidet mit.
Sicherheit: Was darf der Agent?
Je weniger du einem Agenten zuschaust, desto weniger Rechte sollte er haben. Ein Beispiel aus meinem Alltag: Claude hat bei mir keine Administratorrechte, das ist im Harness deaktiviert. Um einen Ordner mit Dateien des Systembenutzers zu löschen, hat er mit seinem eigenen Benutzer einen Docker-Container gestartet, den Ordner hineingehängt und darin gelöscht. Agenten sind erfinderisch.
Was bei mir deshalb gilt:
- Eigener Benutzer: Der Agent arbeitet in GitLab mit einem eigenen Konto mit Entwicklerrechten.
- Geschützte Hauptzweige: Er kann pushen, aber nichts löschen, auch nicht versehentlich beim „Optimieren“.
- Weniger Zugänge ohne Aufsicht: Agenten, die per Cronjob unbeaufsichtigt laufen, bekommen deutlich weniger Zugangsdaten als der, dem ich zuschaue.
Orchestrator, Subagenten und Kontext
Ein Orchestrator ist ein steuernder Agent: Er zerlegt eine Aufgabe, verteilt die Teile an andere Agenten und führt die Ergebnisse zusammen. Bei mir verteilt er Tickets auf vier parallele Lanes, schaut alle 30 Minuten nach dem Stand und legt am Ende einen Merge-Request an. Die Fenster ordnet Tilix, ein Linux-Terminal, das mehrere Sitzungen als Kacheln in einem Fenster zeigt.
Der Hauptgrund für diese Aufteilung ist das Kontextfenster. Ein Subagent erledigt eine Teilaufgabe mit eigenem Kontext und meldet nur das Ergebnis zurück. So bleibt der Hauptchat frei von Suchergebnissen, Logs und Denkschritten. Wird das Fenster trotzdem voll, greift die Kompaktierung: Der bisherige Verlauf wird zusammengefasst, damit die Arbeit weitergehen kann.
Lokal ist das besonders spürbar. Wer mit 192.000 Tokens Kontext arbeitet und das Modell bei 160.000 Tokens alles neu einlesen lässt, wartet gut fünf Minuten auf den Prefill.
Hardware für lokale Modelle
Die Grenze lokaler Modelle ist meist der Speicher. Die Hoffnung liegt auf HBM, gestapeltem Speicher direkt am Prozessor mit sehr breiter Anbindung, der bisher Rechenzentrumskarten vorbehalten ist. Eine solche Karte ist die NVIDIA B200: Im DGX B200 arbeiten acht Stück mit zusammen 1.440 GB Grafikspeicher. Am anderen Ende steht die RTX 5090, eine Consumer-Karte mit 32 GB GDDR7-Speicher. Was das für deine Planung bedeutet, steht in Grafikkarte für lokale KI: eine teure oder mehrere günstige?.
Gedächtnis und Wissen
Ein Agent, der aus seinen Fehlern lernt, arbeitet besser. Bei mir speichert ein Hook am Ende jedes Chats den Verlauf als Datei. Nachts wertet ein Agent aus, welche Fehler passiert sind und welche Lösung am Ende funktioniert hat, und schreibt daraus Hinweise für das nächste Mal. Schlanker geht es, wenn du dir am Ende eines Chats eine kurze Zusammenfassung erstellen lässt und nur die in deine Wissensdatenbank übernimmst.
Im Grunde ist das RAG: Das Modell sucht vor der Antwort in eigenen Dokumenten und stützt sich auf aktuelle, interne Daten statt nur auf sein Trainingswissen. Meine Wissensdatenbank liegt in Obsidian als verlinkte Markdown-Dateien in einem eigenen Git-Repository.
Wichtig bei lokalen Modellen: Wissen gehört in die Datenbank, nicht in die Anweisungen des Agenten. Jedes Token, das ohne Not im Kontext steht, kostet lokal Minuten.
Fazit
Ein Coding Harness macht aus einem Sprachmodell ein Werkzeug. Für die meisten Aufgaben ist ein fertiger Harness die richtige Wahl, und Skills, Hooks und klare Rechte bringen mehr als ein Eigenbau. Was sich in feste Regeln fassen lässt, überlässt du klassischem Code. Wer lokal arbeitet, wählt für jede Aufgabe das passende Modell und hält den Kontext klein.
Wie sich lokale Modelle im direkten Vergleich schlagen, zeigt unser Test Coding Agents im Test: lokal gegen Claude Code und Codex. Was ein eigener KI-Server kostet, steht auf der Seite KI-Server kaufen oder mieten.
Tipp: Das ganze Gespräch mit Frank, Dennis und mir gibt es als Folge 3 von DREI ITler EIN PODCAST auf YouTube.
Was hier beschrieben ist,
lässt sich umsetzen.
Sie haben konkrete Fragen zum Einsatz von KI in Ihrem Unternehmen? Wir schauen uns gemeinsam an, was davon für Ihren Fall realistisch und sinnvoll ist.
- 30 Minuten, kostenlos und unverbindlich
- Konkrete Einschätzung für Ihr Unternehmen
- Rückmeldung innerhalb eines Werktages
Kommentare
Noch keine Kommentare. Sei der Erste!
Kommentar schreiben
Kommentare werden nach manueller Prüfung freigeschaltet.